
Die kurze Antwort
Bei unseren vier konstruierten Dokumenten mit je vier Seiten waren die Vektor-PDFs 4.463–31.095 Byte groß; alle 24 Rastervarianten waren größer. Eine niedriger aufgelöste PNG-Ausgabe war nicht durchgehend kleiner. Gemessen wurde unser lokaler Exportablauf, nicht LinkedIn-Verarbeitung, menschliche Lesbarkeit oder Interaktion. Alle Bedingungen stehen zum Prüfen bereit.
Das nimmst du mit
- Alle vier Entwürfe und sieben Bedingungen bleiben erhalten, auch überraschende Ergebnisse.
- Auflösung, Kompression, Textstruktur und angezeigte Lesegröße sind verschiedene Entscheidungen.
- Der Versuch ist reproduzierbare Dateiforschung, keine Leserstudie oder Plattformempfehlung.
Fragestellung und kontrollierte Eingaben
Beim Karussellexport stehen oft PDF, Bildqualität und Auflösung zur Wahl, ohne dass klar ist, welche Eigenschaft sich ändert. Unsere enge Frage: Wie beeinflussen Vektorinhalt, Rasterauflösung und JPEG-Qualität bei eigenen Text- und Formdokumenten Dateigröße und dargestellte Pixel? Das Protokoll wurde vor den Exporten am 31. Oktober 2026 festgehalten.
Wir erstellten vier eigene Dokumente mit je vier Seiten: eine sparsame Erklärung, eine dichte Zahlentabelle, ein Ablaufdiagramm und ein bewusst detailreiches synthetisches Muster. Die quadratischen Seiten messen 540 PDF-Punkte. Texte, Werte und Formen sind konstruierte Versuchsmaterialien. Reale Kunden, Kontodaten, fremde Bilder oder Fotografien werden nicht verwendet. Das Muster ersetzt keinen fotografischen Datensatz.
Es handelt sich um einen automatisierten eigenen Exportversuch von Wrapped.li. Er ist keine unabhängige menschliche Prüfung, kein Test aller Gestaltungsprogramme und keine Beobachtung der LinkedIn-Verarbeitung. Die Beispiele wurden für diese Frage erstellt und nicht aus erfolgreichen Beiträgen ausgewählt.
Sieben Bedingungen für jedes Dokument
Jedes Dokument wurde als Vektororiginal, PNG mit 1080, 720 und 540 Pixeln Seitenbreite, JPEG mit 1080 Pixeln und Qualität 90 sowie 70 und JPEG mit 720 Pixeln bei Qualität 70 ausgegeben. Rasterseiten beginnen mit derselben 1080-Pixel-Darstellung ihres Vektororiginals. Jedes Bild wird bei unveränderter Geometrie von 540 Punkten in eine PDF eingebettet. JPEG verwendet 4:4:4-Farbabtastung.
Verwendet wurden pdf-lib 1.17.1, sharp 0.35.5, Poppler pdftoppm 26.05.0 und Node 24.21.0. Metadatenzeiten sind festgelegt. Der öffentliche Generator enthält Quelldefinitionen und Befehle; die JSON-Datei dokumentiert Versionen, Einstellungen, Seitenmessungen und SHA-256-Prüfsummen. Das vollständige Paket enthält alle 28 PDFs statt einer bevorzugten Auswahl.
Beim Auflösungsvergleich innerhalb PNG bleibt die Codierungsmethode gleich, beim JPEG-Qualitätsvergleich die Auflösung von 1080 Pixeln. Vektor gegen Raster verändert Darstellung und Wiedergabe ebenso wie Codierung und isoliert deshalb keinen einzelnen Kompressionseffekt. Ein zweiter vollständiger Lauf reproduzierte alle 28 PDF-Prüfsummen und Seitenmessungen in dieser Umgebung exakt.
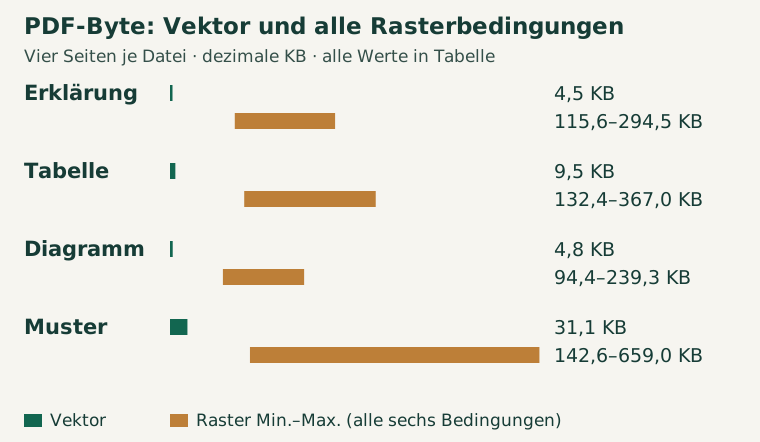
Eine kleinere Rasterauflösung ergab nicht immer kleinere Dateien
Die Tabelle zeigt genaue Bytewerte für alle sieben Bedingungen. Jedes Vektororiginal blieb kleiner als sämtliche Rastervarianten desselben Dokuments. Bei der dichten Tabelle waren es 9.540 Byte als Vektor, 244.027 als 1080-PNG und 240.699 als 1080-JPEG mit Qualität 70. Gemessen werden vollständige vierseitige PDF-Dateien einschließlich Dokumentaufwand.
Alle 720-Pixel-PNGs waren in diesem Ablauf größer als ihre 1080-Pixel-Pendants. Neuberechnete Kantenfarben ändern die komprimierbaren Muster. Das Ergebnis warnt davor, bei Text- und Formdokumenten weniger Pixel automatisch mit weniger Byte gleichzusetzen. Es belegt nicht, dass höhere Auflösung immer Platz spart. JPEG-Qualität 70 senkte bei 1080 Pixeln für alle vier Dokumente die Größe gegenüber Qualität 90.
| Bedingung | Erklärung | Tabelle | Diagramm | Muster |
|---|---|---|---|---|
| Vektor | 4.463 | 9.540 | 4.831 | 31.095 |
| PNG 1080 | 153.609 | 244.027 | 134.025 | 142.620 |
| PNG 720 | 235.679 | 292.399 | 176.779 | 343.805 |
| PNG 540 | 160.038 | 194.840 | 120.384 | 259.327 |
| JPEG 90 / 1080 | 294.503 | 366.976 | 239.270 | 658.972 |
| JPEG 70 / 1080 | 206.155 | 240.699 | 169.218 | 455.090 |
| JPEG 70 / 720 | 115.552 | 132.390 | 94.367 | 327.710 |
Pixelabweichung misst einen Ablauf und keine Leser
Jede PDF-Seite wurde mit Poppler auf 360 × 360 Pixel dargestellt und mit derselben Seite des Vektororiginals verglichen. Berechnet wird die Wurzel des mittleren quadratischen RGB-Fehlers über alle Farbkanäle und Pixel; die vier Seitenfehler werden pro Dokument gemittelt. JSON und CSV enthalten auch alle Einzelwerte. Das Vektororiginal hat definitionsgemäß Fehler null, keinen bereinigten Qualitätssieg.
Bei PNG aus 1080 Pixeln lagen die mittleren Fehler zwischen etwa 18,96 beim Diagramm und 38,19 beim Muster auf der Kanalwertskala 0–255. Bei 540 Pixeln waren es 21,22 bis 44,40. Kantenglättung, Bildinterpolation und Pixelausrichtung beeinflussen die Abweichung auch bei verlustfreiem PNG. Eine Grenze menschlicher Lesbarkeit wurde nicht gemessen.
Repräsentative dargestellte Seiten wurden auf Export- und Layoutfehler angesehen; Beispielansichten und Dateien sind veröffentlicht. Es gab keine Leseraufgaben, Zeichenerkennung durch Teilnehmer, Hilfsmitteltests, OCR-Genauigkeitsprüfung oder repräsentative Gestaltungsauswahl. Ein kleiner Messunterschied belegt keine sichtbar gleiche Qualität.
Ähnliche Bilder können andere Dokumentstrukturen enthalten
Zusätzlich wurden Textzeichenblöcke und eingebettete Seitenbilder in den dekodierten PDF-Inhaltsströmen gezählt. Die Vektororiginale enthalten über vier Seiten 24 Textblöcke für die Erklärung, 136 für die Tabelle, 28 für das Diagramm und 16 für das Muster. Jede Rasterdatei enthält keinen solchen Block und ein eingebettetes Seitenbild pro Seite. Das ist eine Strukturmessung und kein erfolgreicher Textauslese- oder Screenreadertest.
W3C empfiehlt tatsächlichen Text statt reiner Textbilder im PDF und beschreibt Prüfungen auf Vollständigkeit und Reihenfolge. Unsere ungetaggten Versuchsdokumente sind durch Textzeichenoperationen allein nicht als barrierefrei bestätigt. Weder Dateigröße noch Pixelähnlichkeit belegen Lesereihenfolge, sinnvolle Tags, richtige Sprache oder hilfreiche Beschreibungen.
Aus dem Ergebnis die nächste Prüfung ableiten
Prüfe bei eigenen Text- und Formdokumenten zuerst einen Export mit erhaltenem Text und Vektorinhalt. Kontrolliere tatsächliche Größe, Textverhalten und kleine Ansicht, bevor du rasterst oder komprimierst. Sind Bilder nötig, ändere Auflösung oder Codierung kontrolliert am tatsächlichen Material. Bewahre die bearbeitbare Quelle auf, statt eine bereits verschlechterte Kopie wiederholt zu komprimieren.
Zur Reproduktion dient der veröffentlichte Generator mit den festgehaltenen Paketversionen und vorhandenem pdftoppm. Vergleiche Prüfsummen und Seitenmessungen mit results.json. Andere Renderer, Bibliotheksversionen, Schriften oder Vorgaben können Bytewerte und Pixel verändern. Verwendet wird Base-14 Helvetica und kein umfassender mehrsprachiger Schriftdatensatz. Aussagen über Fotografien, alle Programme oder Geräte folgen daraus nicht.
Ein Veröffentlichungsziel kann Dateien erneut verarbeiten. Dieser Versuch lud nichts bei LinkedIn hoch, maß weder dessen Kompression noch Publikum oder Umsatz. Sein Nutzen sind überprüfbare Dateien und ein begrenztes Prüfverfahren. Welche öffentliche Fassung echten Menschen beim Erledigen ihrer Aufgabe hilft, braucht weiterhin eine eigene Leserstudie.
Quellen & Produktinformationen
Produktangaben beziehen sich auf den Stand dieser Veröffentlichung. Externe Funktionen und Oberflächen können sich ändern.


